
ACTUALITÉS IA · DÉCRYPTAGE
Édition du 16 octobre 2026 · Annonces et documentations officielles.
Dans un bus, un boîtier analyse les montées et les descentes. Dans une usine, un logiciel examine des images de pièces. Dans un centre de supervision, une équipe cherche une séquence précise. Ces situations ont un point commun : transformer un flux d’images en une information exploitable, avec une contrainte de temps, d’énergie et de fiabilité.
Les actualités de NVIDIA éclairent cette évolution de la computer vision, ou vision par ordinateur. Les GPU progressent, mais le mouvement se joue aussi dans les bibliothèques de traitement d’image, les logiciels vidéo et les modèles capables de relier une scène à une question. Pour les exploitants, l’enjeu est de comprendre ce que ces nouveautés permettent réellement de construire.
Plus près du terrain
Le calcul embarqué ouvre des architectures adaptées aux véhicules et aux sites distribués.
Plus de contexte
Les modèles vision-langage ajoutent une lecture sémantique aux traitements vidéo spécialisés.
Une chaîne à mesurer
Mémoire, décodage, logiciel et refroidissement comptent autant que la puissance annoncée.
01 · L’ACTUALITÉ
Trois annonces, trois échelles de calcul
La sélection ci-dessous met en regard une bibliothèque d’inspection, une plateforme de calcul et une boîte à outils vidéo. Ce sont des avancées de nature différente : leur intérêt dépend du problème à résoudre.
14 OCTOBRE 2026 · INDUSTRIE
L’inspection se joue aussi dans le logiciel
NVIDIA présente les usages de ses bibliothèques CUDA-X dans la fabrication de semi-conducteurs. KLA a contribué à l’optimisation d’un noyau NPP de traitement d’image. NPP est accessible dans CUDA Toolkit : cette annonce porte notamment sur le logiciel, pas sur une nouvelle carte graphique.
30 SEPTEMBRE 2026 · INFRASTRUCTURE
Rubin entre en production chez CoreWeave
NVIDIA annonce les premiers usages clients de Vera Rubin NVL72 chez CoreWeave, avec Cognition. Le fournisseur précise une disponibilité limitée. Il s’agit d’une infrastructure pour de grandes charges d’IA, dont l’arrivée ne préjuge pas du matériel nécessaire à un projet vidéo local.
29 SEPTEMBRE 2026 · VIDÉO
VSS rapproche vidéo et langage
NVIDIA présente les nouveautés de VSS Blueprint 3.3 pour construire des applications de recherche, d’analyse et de contextualisation vidéo. L’échantillonnage adaptatif réduit notamment le travail consacré aux parties d’image inchangées. Les nouveautés sont présentées dans le billet ; le dépôt marque encore 3.2.1 comme dernière release au jour de cette édition.
Notre lecture : l’innovation ne se concentre plus sur un composant isolé. Elle concerne toute la circulation de l’information, depuis la préparation des images jusqu’à leur interprétation. C’est cette chaîne complète qu’un projet de computer vision doit faire fonctionner durablement.
02 · COMPRENDRE LE MATÉRIEL
Une carte graphique ne traite jamais un projet toute seule
Un GPU est un processeur conçu pour effectuer de nombreux calculs en parallèle. La carte graphique ou carte accélératrice est le matériel qui l’intègre, avec sa mémoire et son interface avec le serveur. En vision par ordinateur, l’inférence consiste à faire fonctionner un modèle déjà entraîné sur de nouvelles images : détecter un objet, classer une scène ou produire une description.
Avant cette étape, le flux doit être reçu, décodé et préparé. Après, il faut organiser les résultats, suivre les objets si le scénario le demande et transmettre une information à une application. La documentation DeepStream distingue ces opérations et les répartit entre plusieurs moteurs matériels et logiciels. Un blocage dans le décodage, la mémoire ou le réseau peut donc limiter l’ensemble. Voir l’architecture vidéo documentée par NVIDIA.
LE SCHÉMA · 01
Ce qui se passe entre une caméra et un événement.

RTX PRO : regarder la mémoire et la vidéo aussi
La RTX PRO 4500 Blackwell Server Edition illustre cette approche. NVIDIA la présente comme disponible et annonce 32 Go de mémoire GDDR7, une puissance maximale de 165 W, un format simple emplacement et trois moteurs de décodage vidéo. Ce sont des repères d’intégration concrets pour un serveur. Ils ne donnent pas, à eux seuls, un nombre de caméras : celui-ci dépend des flux, des modèles, de leur fréquence d’exécution et des autres traitements. Fiche officielle de la RTX PRO 4500.
03 · AU PLUS PRÈS DES CAMÉRAS
Jetson : penser l’IA à l’échelle d’un véhicule ou d’un site
Jetson désigne une plateforme de calcul embarqué, pas une carte graphique de bureau miniature. Ses modules réunissent notamment CPU et GPU dans un ensemble destiné à être intégré à un équipement. Avec Thor, NVIDIA poursuit cette approche pour des applications d’IA plus complexes au plus près des capteurs. Présentation de la plateforme Jetson Thor.
L’évolution est aussi logicielle. Publié le 11 août 2026, JetPack 7.2.1 s’appuie sur Jetson Linux 39.2.1 et prend en charge les familles Thor et Orin. Une base logicielle commune facilite le travail d’intégration ; elle ne rend pas les capacités des modules identiques. Le choix du matériel et la validation de l’application restent propres à chaque projet. Annonce JetPack 7.2.1 et matrice officielle des versions.
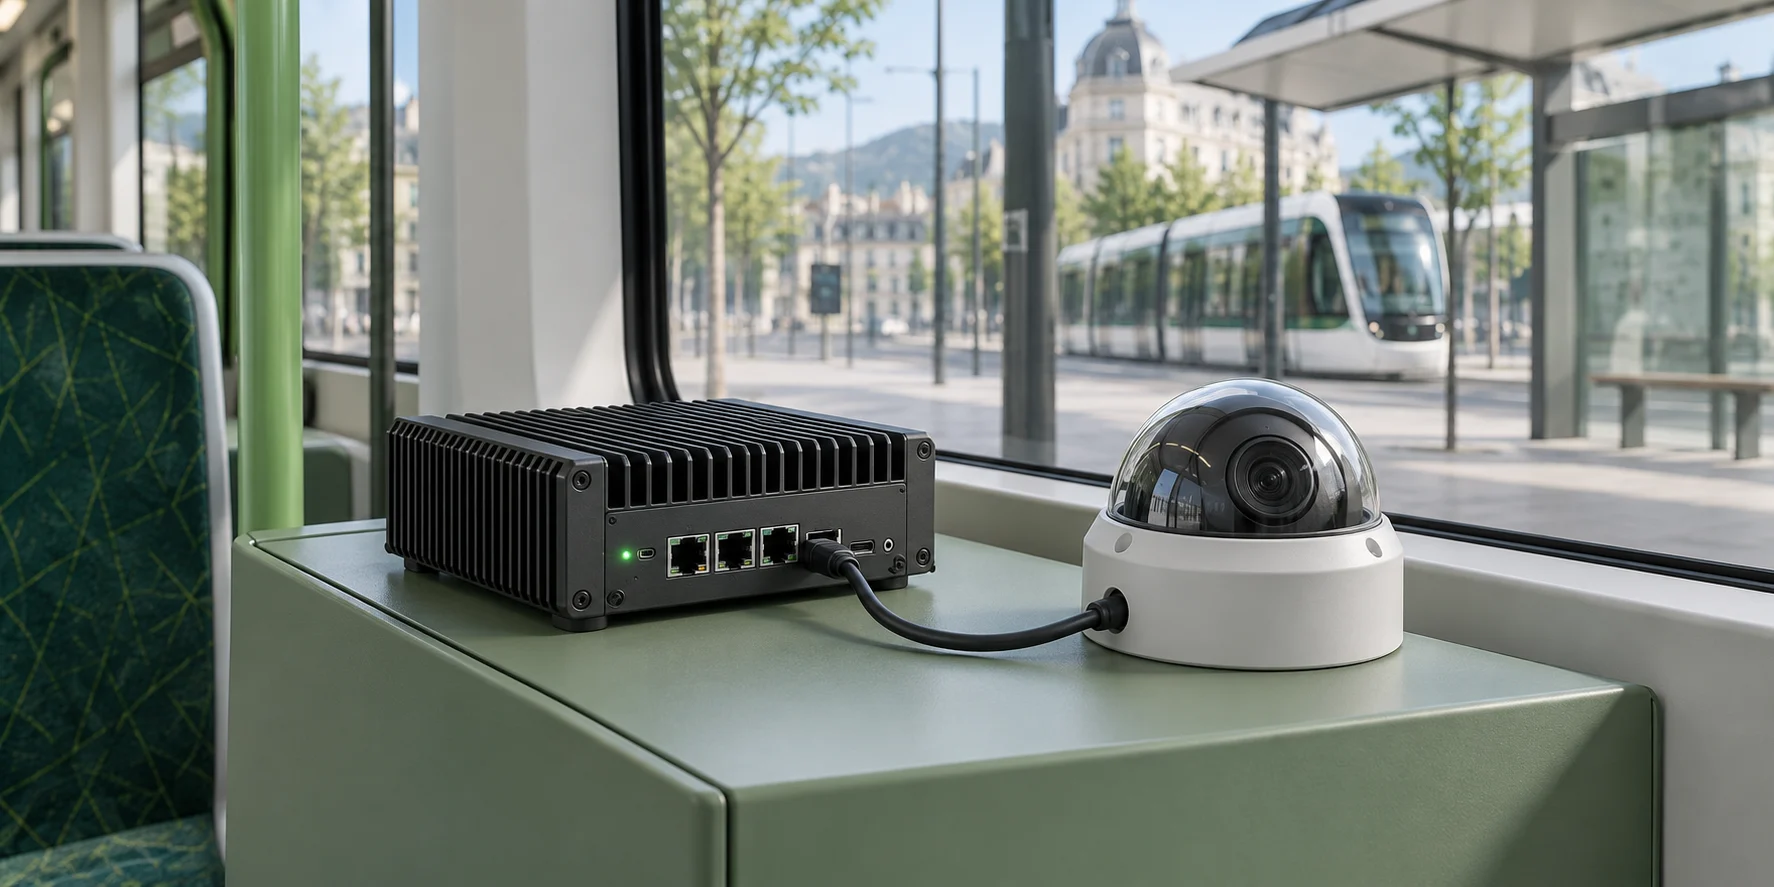
Dans un bus ou un train, analyser localement certaines images peut permettre de produire des indicateurs de fréquentation sans dépendre d’un transfert vidéo permanent. Mais l’intégration doit tenir compte des démarrages, des interruptions de liaison, de la température, de l’alimentation et de la maintenance. Le logiciel doit également préciser quelles données sont conservées et ce qui se passe quand la connexion revient.
Le même raisonnement vaut dans un bâtiment ou sur un site industriel : placer le calcul près de la source peut répondre à des contraintes de réseau et de délai. Centraliser plusieurs flux sur un serveur peut, à l’inverse, simplifier la mutualisation et l’exploitation. Ces choix peuvent coexister dans une même organisation.
04 · DES PIXELS AU CONTEXTE
Détecter un objet, puis comprendre une séquence
La computer vision spécialisée répond à des questions précises : un véhicule franchit-il une ligne, combien de personnes passent, une zone est-elle occupée ? Les modèles vision-langage, ou VLM, associent des images à une consigne textuelle. Ils peuvent enrichir une recherche ou proposer une description de séquence. Le résultat attendu et la manière de le vérifier ne sont pas les mêmes.
DeepStream 9.1.0, publié le 14 juillet 2026, prolonge la boîte à outils NVIDIA pour les applications vidéo, avec notamment le support des Jetson Orin dans cette génération du SDK. Pour les équipes techniques, suivre la bonne combinaison de SDK, pilotes et système d’exploitation est une condition de déploiement. Releases officielles et notes DeepStream 9.1.
NVIDIA documente aussi une application de référence qui relie DeepStream à vLLM pour analyser des segments vidéo avec un VLM. Elle traite les segments de façon asynchrone et peut partager un modèle entre plusieurs flux. Sa documentation indique au moins 40 Go de mémoire GPU et un support actuel des plateformes x86 avec GPU : il ne faut donc pas déduire de cette démonstration une disponibilité identique sur tous les Jetson. Prérequis de l’application VLM.
La performance utile, c’est une information fiable, produite au bon moment, dans les contraintes du terrain.
Une architecture possible consiste à exécuter en continu un traitement spécialisé, puis à réserver une analyse plus riche aux séquences pertinentes. C’est une piste de conception, à évaluer selon le besoin. Une description générée peut être erronée : pour une situation de sûreté, elle doit rester vérifiable à partir de la séquence et s’inscrire dans une procédure de qualification humaine.
LE SCHÉMA · 02
Trois lieux de calcul, des contraintes différentes.

05 · LIRE LES PERFORMANCES
Quatre mesures qui valent mieux qu’un chiffre spectaculaire
Les résultats publiés par un constructeur décrivent un matériel, un logiciel et une charge de travail donnés. Le débit d’un grand modèle de langage, la vitesse d’un noyau de traitement d’image et le nombre de flux vidéo analysés ne sont pas interchangeables. Pour comparer deux configurations, il faut conserver le même scénario et regarder le service rendu.
La qualité du résultat
Pour le comptage, comparer à un relevé de référence. Pour une alerte, examiner les détections utiles, les fausses alertes et les situations manquées. Répéter la mesure sur des scènes représentatives.
Le délai de bout en bout
Mesurer le temps entre l’événement filmé et son exploitation. Inclure la capture, le réseau, le décodage, le traitement et l’affichage, pas seulement le temps passé dans le modèle.
La charge réellement tenue
Préciser le nombre de flux simultanés, leur résolution, leur codec et la fréquence d’analyse. Vérifier l’usage de la mémoire et les pertes d’images pendant les pointes d’activité.
L’exploitation dans la durée
Observer la consommation, la température, la reprise après incident et la maintenance. Une démonstration de quelques minutes ne décrit pas un équipement fonctionnant tous les jours.
Le progrès matériel devient intéressant lorsqu’il permet d’améliorer l’un de ces critères sans dégrader les autres. Une optimisation logicielle peut également libérer de la capacité sur une infrastructure existante. La décision se prend à partir des mesures du projet, et du coût de son exploitation.
06 · LA PERSPECTIVE VIDETICS
Partir du scénario, puis choisir l’architecture
Compter les passagers dans les transports, comprendre les flux sur un site ou aider une équipe à examiner une alerte appelle des configurations différentes. L’actualité des GPU et des modèles élargit les possibilités ; elle ne remplace ni l’étude des caméras, ni la définition des indicateurs attendus, ni l’intégration aux outils des équipes.
Chez Videtics, le travail sur NVIDIA Jetson s’inscrit notamment dans cette logique d’embarqué. Le sujet est de rapprocher l’analyse des usages tout en tenant compte des contraintes physiques et opérationnelles. Les annonces examinées ici constituent une veille technologique : elles ne sont pas une liste de fonctionnalités ou de matériels déjà validés avec Perception.
Quel calcul pour vos images ?
Explorez Videtics Perception et ses intégrations, puis préparez les flux, les scénarios et les contraintes de votre installation.
Sources et méthode
Édition arrêtée au 16 octobre 2026. Les dates d’annonce, les versions publiées et les périmètres de disponibilité sont distingués. Les interprétations terrain sont celles de la rédaction ; aucun gain annoncé n’est transposé à une solution Videtics.
- NVIDIA Newsroom, bibliothèques CUDA-X et fabrication des semi-conducteurs, 14 octobre 2026.
- NVIDIA Blog, Vera Rubin chez CoreWeave, et précisions du fournisseur sur l’accès limité, 30 septembre 2026.
- NVIDIA Technical Blog, nouveautés VSS Blueprint 3.3, 29 septembre 2026 ; release VSS 3.2.1, 23 juillet 2026.
- NVIDIA, fiche RTX PRO 4500 Blackwell Server Edition et plateforme Jetson Thor, consultées le 16 octobre 2026.
- NVIDIA Technical Blog, JetPack 7.2.1, 11 août 2026 ; versions et compatibilités JetPack.
- NVIDIA, releases DeepStream, notes 9.1, architecture vidéo et application de référence VLM, consultées le 16 octobre 2026.
Visuels générés par IA : matériels et installation fictifs, sans reproduction d’un produit NVIDIA précis. Schémas de principe : Videtics Journal. Article rédigé avec l’assistance d’une IA.